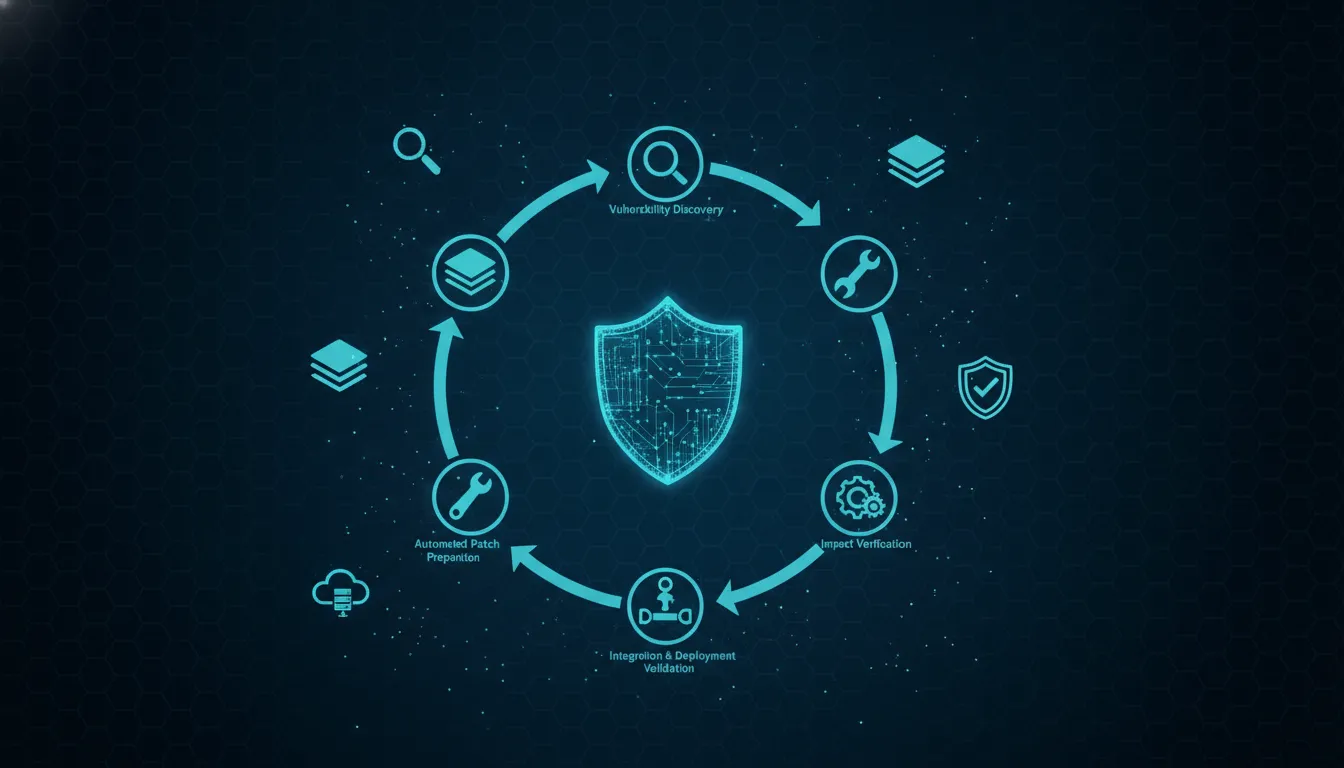
OpenAI na DevDay 2026 představila rozšířený přístup k zabezpečení softwaru pomocí AI: nejen hledat chyby, ale také ověřovat jejich skutečný dopad, odstraňovat duplicitní hlášení, připravovat opravy a kontrolovat, zda zranitelnost opravdu zmizela. Codex Security má tento postup zpřístupnit prostřednictvím otevřených nástrojů i více automatizované cloudové služby.
Za nejdůležitější posun považuji propojení jednotlivých kroků. Samotný seznam podezřelých míst totiž bezpečnější aplikaci nezaručuje. Rozhodující je, zda se ověřený problém dostane ke správnému týmu, zda vznikne použitelná oprava a zda projde běžným vývojovým procesem až do produkce.
OpenAI tento přístup odvozuje od vlastní interní bezpečnostní iniciativy. Do intenzivního bezpečnostního sprintu zapojila čtvrtinu produktových inženýrů a následně z něj vybudovala průběžný systém vyhledávání a odstraňování zranitelností. Výsledkem má být méně jednorázového hašení a více soustavné obrany, která se přizpůsobuje změnám v kódu.
Obsah
- 🛡️ Bezpečnostní náskok má podle OpenAI omezené trvání
- 🏭 Interní bezpečnostní sprint se změnil v průběžnou obranu
- 🧰 Codex Security nabízí stavebnici i hotovější službu
- 🧭 První krok: dát bezpečnostnímu agentovi správný kontext
- 📚 Bezpečnostní dokumentace se stává součástí repozitáře
- 🔎 Hloubkové skenování pracuje paralelně a ve více průchodech
- 🧹 Deduplikace odstranila více než třetinu hlášení
- 🎯 Závažnost a vlastnictví určují, co se opravdu opraví
- 🩹 Automatické opravy se mají zavádět postupně
- ✅ Ověřená oprava musí obstát proti původní zranitelnosti
- 📈 Lepší modely mají zvyšovat kvalitu a snižovat cenu oprav
- 🔄 Po velkém úklidu musí následovat průběžná kontrola
- ☁️ Codex Security Cloud přebírá organizaci bezpečnostního cyklu
- 🚀 Co si z nového přístupu odnáším pro vlastní projekty
🛡️ Bezpečnostní náskok má podle OpenAI omezené trvání
Výchozí argument prezentace byl naléhavý: schopnosti AI v kybernetické bezpečnosti rostou a náklady na hledání zneužitelných chyb klesají. Ian z týmu kybernetického produktového inženýrství OpenAI uvedl, že nejnovější modely během několika měsíců umožnily objevit tisíce dosud skrytých zranitelností v běžně používaném softwaru.
Nejde přitom jen o téma pro specializovaná bezpečnostní oddělení. Pokud lze slabiny vyhledávat rychleji a ve větším rozsahu, dotýká se to každého, kdo vyvíjí aplikace. Stejná schopnost může pomoci obráncům i útočníkům. Rozdíl spočívá v tom, kdo ji dokáže včas zapojit do svého pracovního postupu.
OpenAI tuto situaci označuje jako časové okno pro obránce. Podle jejího hodnocení mají nejpokročilejší modely v kybernetických schopnostech náskok před modely s otevřenými vahami. Organizace tak mohou využít období, během něhož mají příležitost slabiny najít a opravit dříve, než se srovnatelné možnosti stanou široce dostupnými.
Tento argument čtu jako výzvu k praktické práci, nikoli jako příslib trvalé technologické převahy. Hodnota náskoku závisí na tom, zda se promění v odstraněné zranitelnosti. Lepší skener sám o sobě nepomůže, pokud jeho výsledky zůstanou ležet v dlouhé frontě nevyřízených úkolů.
🏭 Interní bezpečnostní sprint se změnil v průběžnou obranu
OpenAI podle svého popisu pojala zabezpečení systémů jako celofiremní prioritu. Vyčlenila lidi, čas i další zdroje a čtvrtina jejích produktových inženýrů se během bezpečnostního sprintu věnovala výhradně posilování interních systémů. Tak rozsáhlé zapojení mělo pomoci nejen s hledáním chyb, ale především s jejich skutečným odstraněním.
Z této práce vznikl interní systém nazývaný „továrna na obranu“. Název může znít průmyslově, princip je ale srozumitelný: bezpečnost nemá být jednorázová kontrola, nýbrž opakující se cyklus s jasnými návaznostmi.
- Průběžně procházet systémy a hledat možné zranitelnosti.
- Ověřovat, které nálezy mohou vést ke skutečnému zneužití.
- Sloučit opakovaná hlášení stejného problému.
- Určit závažnost a odpovědný tým.
- Připravit opravu a ověřit její účinnost.
OpenAI uvedla u takto zpracovaných nálezů míru falešně pozitivních výsledků 0,81 %. U oprav vytvořených s pomocí Codexu zároveň popsala podíl vrácených změn nižší než jedno procento. Jde o dva různé ukazatele: první se vztahuje ke kvalitě nálezů, druhý k následným opravám.
Tyto výsledky nepovažuji za univerzální záruku pro libovolný repozitář. Ukazují však, proč firma staví na celém procesu, nikoli pouze na schopnosti modelu přečíst kód. Nízký počet chybných hlášení i vrácených oprav spojuje s kontextem, validací a zavedenými kontrolami.
🧰 Codex Security nabízí stavebnici i hotovější službu
Zkušenosti z interního nasazení OpenAI promítla do Codex Security. Představená nabídka zahrnuje otevřený zásuvný modul, nástroj pro příkazovou řádku, označovaný jako CLI, a vývojářskou sadu SDK. Vedle nich stojí Codex Security Cloud, který má větší část průběžného bezpečnostního procesu organizovat automaticky.
CLI představuje sadu základních operací, z nichž si tým může sestavit vlastní pracovní postup. Kyle, který se v týmu zaměřuje právě na tento nástroj, ukázal cestu od zadání kontextu přes skenování a obohacování nálezů až po opravy a jejich začlenění do vývoje.
Nástroj pro příkazovou řádku je podle představení plně otevřený a dostupný pod licencí Apache 2.0. Pro technické týmy je podstatná zejména možnost přizpůsobit jeho použití vlastní infrastruktuře a zavedeným pravidlům.
Rozdíl mezi jednotlivými variantami vnímám především jako rozdíl v míře orchestrace. CLI a SDK poskytují stavební kameny. Cloudová služba z nich nabízí hotovější provozní celek. Samotné rozhodnutí proto není jen otázkou pohodlí, ale také toho, kolik vlastního řízení chce tým zachovat.
V obou případech zůstává cíl stejný: dostat se od podezření na chybu k ověřené změně, kterou lze předat do běžného procesu kontroly a nasazení softwaru.
🧭 První krok: dát bezpečnostnímu agentovi správný kontext
Jedna z nejpraktičtějších zkušeností se týkala zadání. Prosté nasměrování agenta na velký repozitář s požadavkem, aby našel všechny chyby a neudělal žádnou chybu vlastní, se neosvědčilo. OpenAI proto rozdělila kód na menší oblasti a jednotlivým skenům přidělila konkrétnější úkoly.
Agent potřebuje rozumět tomu, co daná komponenta dělá, jak zapadá do celého systému, odkud je dostupná a jaké ochrany ji obklopují. Část těchto informací přitom ve zdrojovém kódu vůbec být nemusí. Bez nich lze snadno zaměnit teoreticky podezřelé místo za skutečně zneužitelnou slabinu.
Konkrétní pokyny pro konkrétní sken
První vrstvu tvoří vlastní instrukce pro danou kontrolu. Ty vymezují oblasti zájmu, určují, co do rozsahu patří a co nikoli, a popisují typy zranitelností, na které se má agent zaměřit. Takové zadání pomáhá soustředit práci místo příliš obecného prohledávání všeho.
Sdílená znalostní báze
Druhou vrstvou je opakovaně použitelný kontext. OpenAI do něj zahrnuje například architektonickou dokumentaci, pravidla přístupu nebo konfiguraci firewallů. Stejné informace mohou dostat jak agenti hledající zranitelnosti, tak agenti, kteří nalezené problémy ověřují.
Za důležité považuji právě toto sdílení. Pokud skener a ověřovací agent vycházejí z odlišné představy o systému, zbytečně vznikají rozpory. Společná znalostní báze má vytvořit jednotný základ pro posouzení toho, co je v konkrétním prostředí skutečně nebezpečné.
📚 Bezpečnostní dokumentace se stává součástí repozitáře
OpenAI začala ukládat bezpečnostní soubory ve formátu Markdown také přímo k jednotlivým komponentám. Jejich účelem je zachytit model hrozeb a bezpečnostní pravidla, za která odpovídají vlastníci dané části produktu. Kontext tak nemusí pokaždé znovu sestavovat centrální bezpečnostní tým.
To má praktický význam i pro spolupráci mezi lidmi. Znalost toho, jak má být komponenta chráněna, se přesouvá z neformálních vysvětlení do podoby, kterou lze opakovaně používat při kontrolách. Agent pak nepracuje jen s tím, jak kód vypadá, ale také s tím, jaké bezpečnostní předpoklady mají platit.
Pro obecné vysvětlení tohoto přístupu je užitečný také přehled modelování hrozeb od OWASP. V kontextu Codex Security je podstatné hlavně propojení modelu hrozeb s konkrétními skeny a jejich vyhodnocením.
Oddělení trvalého kontextu od jednorázových pokynů mi připadá jako malá organizační změna s velkým dopadem. Architekturu nebo pravidla přístupu není třeba opisovat do každého zadání. Konkrétní sken se pak může soustředit na svůj cíl, zatímco společné informace zůstávají dostupné i pro další kroky.
Současně nejde o nahrazení odpovědnosti dokumentem. Právě vlastníci komponent mají definovat své bezpečnostní zásady. Nástroj tuto znalost využívá, ale její správné zachycení zůstává součástí práce týmu.
🔎 Hloubkové skenování pracuje paralelně a ve více průchodech
V ukázce CLI následoval hloubkový sken vzorového repozitáře. Dostal jak konkrétní instrukce, tak soubor se sdílenými informacemi o architektuře a přístupových pravidlech. Nešlo tedy pouze o spuštění modelu nad zdrojovými soubory bez dalšího vedení.
Hloubkové skenování spouští několik bezpečnostních kontrol souběžně. Agenti zkoumají možné zranitelnosti, ověřují je a jejich výsledky se spojují. Další průchody pokračují, dokud systém nenachází nové problémy nebo nedosáhne nastaveného limitu.
Takový postup má dvě důležité vlastnosti. Umožňuje rozdělit rozsáhlou práci mezi více agentů a zároveň se neomezit na jediný průchod. Důkladnost ovšem znamená také časovou náročnost. V představení bylo výslovně uvedeno, že hloubková kontrola celé kódové základny může trvat poměrně dlouho.
Interní nasazení OpenAI bylo ještě rozsáhlejší: zahrnovalo stovky agentů na různých hostitelích, kteří kontrolovali různé části repozitářů. Právě v této fázi se ukázalo, že škálování detekce vytváří nové organizační problémy. Více kontrol totiž přináší nejen více užitečných zjištění, ale také více překryvů.
Proto bych úspěšnost takového nasazení neposuzoval podle samotného počtu nalezených položek. Podstatnější je, kolik jedinečných a ověřených problémů dokáže systém předat dál v podobě, se kterou lze rozumně pracovat.
🧹 Deduplikace odstranila více než třetinu hlášení
Prvním velkým úzkým místem interního sprintu byla podle Kyla deduplikace. Z různých skenerů přicházely desetitisíce nálezů a před jejich předáním vývojářům bylo nutné zjistit, které popisují stejnou základní zranitelnost.
To není jen otázka podobného názvu. Několik agentů může ke stejnému problému dojít různými cestami a popsat jej odlišně. Bez sloučení by jeden tým mohl dostat mnoho úkolů, přestože by všechny vyřešila jediná oprava. Zvyšoval by se objem administrativy, nikoli skutečná bezpečnostní hodnota.
OpenAI uvedla, že 36 % nálezů z jejích skenů tvořily duplicity. Jejich odstranění znamenalo méně opakovaného vyšetřování a méně zbytečné práce pro vývojáře. Při objemu desítek tisíc hlášení už přitom nebylo realistické spoléhat jen na ruční třídění.
Z interní zkušenosti proto vznikl deduplikační postup dostupný v CLI. Agenti se zde neuplatňují pouze jako hledači chyb, ale také jako pomocníci při zpracování toho, co už jiné kontroly našly.
Právě tento krok považuji za snadno přehlédnutelný. Atraktivnější je ukázat nově objevenou zranitelnost nebo automatickou opravu. O použitelnosti celého systému však často rozhoduje méně nápadná práce: zajistit, aby se jedna chyba v seznamu úkolů netvářila jako mnoho různých problémů.
🎯 Závažnost a vlastnictví určují, co se opravdu opraví
Po odstranění duplicit následovalo obohacení nálezů. OpenAI potřebovala odpovědět na dvě samostatné otázky: jak důležitý je problém pro firmu a kdo má zajistit jeho odstranění. Ani jednu nebylo možné spolehlivě vyřešit jen obecným popisem zranitelnosti.
Vlastní pravidla pro určování priorit
Firma začala pravidlem, podle něhož jsou kritické zejména zranitelnosti umožňující externím aktérům získat přístup, který mít nemají. Hodnoticí rámec následně několikrát upravila podle toho, jaké nálezy skenery přinášely a jak zapadaly do interního hodnocení rizik.
CLI má umožnit použít taková vlastní pravidla na soubor nálezů a vytvořit prioritizovaný seznam. Stejný princip může využít i samostatný vývojář. Nejde o velikost organizace, ale o jasné vyjádření toho, které dopady jsou pro daný projekt nejdůležitější.
Odpovědný tým není samozřejmost
Přiřazení vlastníka označil Kyle za překvapivě obtížnou část sprintu. V rychle rostoucí společnosti vyžadovalo zjištění, kdo odpovídá za kterou část systému, značné lidské úsilí. Teprve po zachycení těchto pravidel do použitelné podoby bylo možné přidělovat nálezy spolehlivěji.
Zde vidím jasnou hranici samotné detekce. Nález bez vlastníka může být technicky správný, ale provozně neúčinný. Kvalitní bezpečnostní proces proto potřebuje nejen porozumění kódu, ale také mapu odpovědností, která omezuje přehazování úkolů mezi týmy.
🩹 Automatické opravy se mají zavádět postupně
Po ověření, seřazení a přiřazení nálezů přichází samotná oprava. OpenAI zpočátku ponechávala tento krok výrazně v rukou lidí: tým dostal bezpečnostní úkol, vývojář zadal Codexu jeho vyřešení a následně provedl změnu přes návrh na sloučení kódu až do produkce.
S rostoucí zkušeností začala firma opravy připravovat automaticky za vývojáře. Neznamenalo to však jednorázové přepnutí do plně autonomního režimu. Kyle popsal automatizaci jako postupně nastavovanou míru, kterou lze zvyšovat spolu s důvěrou v kvalitu výstupů a s dostupností potřebného kontextu.
Tenhle přístup mi připadá důležitější než samotná možnost generovat kód. Automatická oprava není automaticky vhodná pro každý projekt a každý tým. Představený postup staví na postupném ověřování, že agent rozumí prostředí a vytváří změny, které lze bezpečně začlenit.
V CLI tuto část zajišťuje funkce pro tvorbu oprav. Agent dostane konkrétní nález a může dostat také instrukce, jak spustit vývojové prostředí a změnu otestovat. Výsledkem může být připravený návrh změny v repozitáři.
- Vstupem je konkrétní bezpečnostní problém.
- Doplňující pokyny vysvětlují přípravu prostředí a testování.
- Agent vytvoří návrh opravy.
- Změna pokračuje k ověření a běžné kontrole kódu.
Podíl vrácených automaticky vytvořených oprav byl podle OpenAI nižší než jedno procento. Firma tento výsledek spojuje také s kontrolou, která následovala ještě před jejich sloučením.
✅ Ověřená oprava musí obstát proti původní zranitelnosti
Samostatným krokem je ověření opravy. Codex Security pro něj nabízí funkci, která má znovu posoudit, zda navržená změna skutečně odstranila příslušný bezpečnostní problém. Nestačí tedy pouze přijmout vysvětlení agenta, který opravu vytvořil.
Kyle tento mechanismus přirovnal k agentovi, který vůči opravě postupuje adversariálně. Jeho úlohou je zkoumat změnu kriticky a ověřit, zda nález dál platí. Jde o další kontrolní vrstvu mezi vygenerovaným kódem a rozhodnutím změnu začlenit.
Vytvoření opravy a potvrzení její účinnosti jsou dva odlišné úkoly. Právě jejich oddělení považuji za podstatnou součást celého návrhu. Pokud stejný proces jen vytvoří změnu a následně oznámí úspěch, chybí mu důležitý protitlak.
Ani ověřená oprava ovšem podle představeného postupu neobchází standardní vývojový cyklus. Následuje návrh na sloučení změn a běžná pravidla konkrétní organizace. Ta mohou zahrnovat kontrolu kódu, testování kvality, produktové posouzení nebo jiné požadavky před nasazením.
CLI je v tomto ohledu záměrně flexibilní. Nemá všem organizacím vnutit jeden schvalovací model. Poskytuje bezpečnostní operace, které lze vložit tam, kde dávají smysl v existujícím procesu. Automatizace tak pomáhá připravit práci, ale nenahrazuje všechna pravidla pro její přijetí.
📈 Lepší modely mají zvyšovat kvalitu a snižovat cenu oprav
OpenAI spojila budoucnost tohoto přístupu také s vývojem samotných modelů. Ian představil srovnání v externím hodnocení PatchBench, které používalo schopnost Codex Security připravovat bezpečnostní opravy. Prezentovaný výsledek ukazoval zlepšení kvality i nákladů na jednotlivý případ.
V uvedeném srovnání model označený jako Astra při střední úrovni uvažování překonával model Sol nastavený na velmi vysokou úroveň uvažování, a to za méně než polovinu ceny na případ. Jako orientační bod zazněla také přibližně padesátiprocentní úspěšnost lidského srovnání v OpenAI.
Tato čísla chápu jako výsledek konkrétního hodnocení, nikoli jako obecnou míru úspěšnosti oprav v libovolném projektu. Přenést výsledek benchmarku přímo na vlastní repozitář by znamenalo přehlédnout rozdíly v zadání, kontextu i prostředí.
Důležitější je pro mě provozní argument: pokud se zlepšuje model uvnitř dobře navrženého procesu, může se zlepšovat i celý bezpečnostní systém. Investice do kontextu, ověřování a integrace tak nemusí být navázaná pouze na jednu generaci modelu.
OpenAI uvedla, že na tomto propojení úzce spolupracuje s výzkumnými týmy. Vyjádřila přitom očekávání dalších zlepšení. Jde však o výhled, nikoli o záruku konkrétního výsledku nebo termínu.
🔄 Po velkém úklidu musí následovat průběžná kontrola
Interní zkušenost OpenAI měla podle prezentace dvě výrazně odlišné fáze. Na začátku přišel prudký nárůst práce a velký objem nevyřešených nálezů. Postupně, po jejich zpracování a opravách, firma dospěla do stabilnějšího stavu s menším počtem nově objevovaných zranitelností.
Takový průběh považuji za důležité očekávání pro zavádění podobných nástrojů. První rozsáhlý sken může vytvořit velkou frontu úkolů. Samotný nárůst hlášení proto ještě nepopisuje konečný přínos. Rozhodující je, zda se podaří zásobu problémů postupně zmenšit a udržet ji nízko.
Ve stabilnější fázi se pozornost přesouvá k zachycování nových problémů před sloučením změn a k pravidelným kontrolám existujícího kódu. Jednorázový sprint tak není cílovým stavem. Je spíše cestou k průběžné bezpečnostní údržbě.
CLI a SDK lze podle OpenAI propojit s repozitáři, kontrolou změn i automatizací CI/CD. Jako jednu z možností firma uvedla GitHub Actions. Pro orientaci v této integrační vrstvě poslouží dokumentace GitHub Actions.
Podstatná je návaznost na běžný rytmus vývoje. Kód se mění, a proto se musí opakovat i jeho bezpečnostní posuzování. Bez této vazby by i důkladně vyčištěný repozitář postupně ztrácel výhodu získanou úvodní prací.
☁️ Codex Security Cloud přebírá organizaci bezpečnostního cyklu
Pro týmy, které nechtějí jednotlivé kroky sestavovat samy, OpenAI představila výrazně aktualizovanou službu Codex Security Cloud. Ta má průběžný cyklus provozovat jako hotovější řešení. Základem je připojení repozitářů na GitHubu a nastavení kontrol.
V předvedeném postupu se služba instalovala z nabídky zásuvných modulů v Codexu. Následovalo propojení přes konektor GitHubu a vytvoření skenu, který se měl spouštět při každém novém commitu. Výsledky se zobrazovaly v přehledu napříč organizací.
Z tohoto přehledu bylo možné otevřít jednotlivé nálezy, prozkoumat podrobnosti a volitelně nechat vytvořit opravu. Služba následně připravila návrh změny přímo na GitHubu. Cloudová varianta tak spojuje detekci, práci s výsledky a přípravu nápravy do jednoho průběžného postupu.
Výraznou součástí oznámení byl přístup k modelům třídy Daybreak, navrženým speciálně pro bezpečnostní použití. Jako výchozí model přestavěné cloudové služby OpenAI uvedla Daybreak Blue.
Při oznámení firma uvedla, že nemá být nutné podávat zvláštní žádosti o přístup. Zároveň avizovala dostupnost cloudového modulu v nabídce do konce týdne konání akce. Tyto informace vztahuji k okamžiku představení, nikoli k nezávisle ověřenému současnému stavu služby.
🚀 Co si z nového přístupu odnáším pro vlastní projekty
Hlavní zprávou pro mě není, že AI umí najít další zranitelnost. Podstatnější je snaha propojit celý řetězec práce tak, aby nalezené problémy skutečně mizely z aplikací. Codex Security staví na kombinaci kontextu, ověřování, priorit, odpovědnosti a kontrolovaných oprav.
Pro vlastní zavádění bych z představeného postupu vybral následující pořadí:
- Vymezit rozsah. Rozdělit kód na smysluplné oblasti a určit, co má konkrétní kontrola hledat.
- Připravit kontext. Zpřístupnit architekturu, přístupová pravidla a model hrozeb.
- Zpracovat nálezy. Ověřit je, odstranit duplicity a určit jejich důležitost.
- Přiřadit odpovědnost. Zajistit, aby každý potvrzený problém měl vlastníka.
- Opravy automatizovat postupně. Přidávat automatizaci spolu s důvěrou v její výstupy.
- Kontrolovat výsledek. Ověřit odstranění zranitelnosti a zachovat běžné schvalování změn.
- Cyklus opakovat. Navázat kontroly na změny kódu a pravidelné skenování.
Volba mezi CLI, SDK a cloudovou službou pak závisí hlavně na požadované míře vlastního řízení. Otevřená stavebnice nabízí prostor pro přizpůsobení, cloud přebírá větší část organizace práce. Ani jedna varianta však neodstraňuje potřebu rozumět vlastnímu systému.
Za nejsilnější závěr považuji jednoduché pravidlo: bezpečnostní nález má hodnotu teprve tehdy, když vede k ověřené nápravě. Právě na tuto cestu od objevení slabiny po přijatou opravu se nové pojetí Codex Security soustředí.


